سرزمین های دیگر
گزارش ویژه تحریریه ویکی وبیا

ما از واژه ساخته شده ایم

محمدرضا کریمی ژنوميكس به مطالعه ژن ها و عملكردشان مي پردازد. در تحقيقات مربوط به ژنوميكس مقادير عظيمي از داده ها تجزيه و تحليل مي شود تا درباره اين كه چگونه ژن ها عمل مي كنند و تغيير مي كنند مطالعه شود. ژنوم هم حاوي اطلاعات ارثي است كه از نسلي به نسلي ديگر رسيده.…

calendar_today۱۵ اردیبهشت ۱۳۹۰
•
schedule۵ دقیقه مطالعه
•
visibilityتحلیلی و موثق
•
chat_bubble_outline0 دیدگاه
forumsend
ما از واژه ساخته شده ایم
photo_cameraتحریریه ویکی وبیا
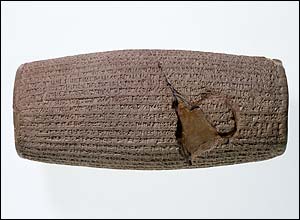
منشور کوروش

محمدرضا کریمی

منشور کوروش

ژنومیکس به مطالعه ژن ها و عملکردشان می پردازد. در تحقیقات مربوط به ژنومیکس مقادیر عظیمی از داده ها تجزیه و تحلیل می شود تا درباره این که چگونه ژن ها عمل می کنند و تغییر می کنند مطالعه شود. 

 ژنوم هم حاوی اطلاعات ارثی است که از نسلی به نسلی دیگر رسیده. کلماتی که ما مورد استفاده قرار می دهیم و داخل کتاب ها می نویسیم هم از نسلی به نسلی دیگر می رسند. 

بنابراین می توان واژه ها را هم یک واحد فرهنگی در نظر بگیریم.

ایدن و ژان باپتیست میشل مدیران «برنامه دینامیک تکاملی» دانشگاه هاروارد، واژه کالچرومیکس را برای تحقیقشان به کار می برند. اصطلاحی که آنها مورد استفاده قرار می دهند، ترکیبی از واژه های کالچر به معنی فرهنگ و ژنومیکس است. اولین میوه کار آنها ایجاد پایگاه عظیم داده ها از واژه های 5.2 میلیون کتابی است که بین سال های 1800 و 2000 منتشر شده است. این میزان کتاب تقریباً چهار درصد همه کتاب های منتشر شده جهان است. آنها در تحقیقشان از پروژه کتاب های گوگل استفاده کردند که کتابخانه اش حاوی 15 میلیون کتاب است.

گوگل نرم افزاری دارد که به همه اجازه دسترسی و تجزیه و تحلیل پایگاه داده های تکمیل شده که حاوی دو میلیارد واژه و عبارت است را می دهد.

محققان می گویند که دانشمندان حوزه های علوم اجتماعی و رایانه و همچنین ریاضیدانان می توانند با پیدا کردن دفعات استفاده از هر واژه، ظهور و تکامل گرایش های فرهنگی را در طول زمان دریابند. ابزار آنها را می توان برای ایجاد جدول زمانی فرهنگی مورد استفاده قرار داد. این ابزار استفاده اندک یا زیاد از واژه های بخصوصی را هم نشان می دهد.

برای مثال واژه توقیف، یک نشانه در تاریخ فرهنگ به جا می گذارد. کتاب های آلمانی زبانی که بین سال های 1936 و 1944 و در دوره سانسور حکومت نازی ها منتشر شدند به ندرت به هنرمندان و فلاسفه مشخصی که بردن نام هایشان قبل و بعد از آن دوره متداول بوده است اشاره می کنند.

همچنین تجزیه و تحلیل ها کلماتی را نشان می دهند که در کتاب های انتشار یافته در این دوره وجود داشته اند اما جایی در لغت نامه ها ندارند. از جمله این کلمات می توان به”aridification”  (به معنی خشک کردن یک منطقه) و deletable (ریشه این کلمه یعنی واژه delete به معنی حذف است) اشاره کرد. این کلمات که به هیچ منبع اطلاعاتی ای متصل نشده اند استثنائات ندارند. بعد از این که محققان همه واژه های موجود در لغت نامه های انگلیسی را جمع بستند بیش از یک میلیون واژه – دو برابر تعداد واژه های موجود در لغت نامه های بزرگ امروزی کلمه شمردند. (برای مثال لغت نامه انگلیسی آکسفورد کمتر از 500 هزار نوشته دارد.)

ایدن امیدوار است محققان بسیاری از رشته ها راه های جدیدی برای بهره برداری از این داده ها پیدا کنند. وی می گوید:«این ابزار دیگری است که در دسترس انسان شناسان قرار گرفته تا بینشی نو به دست آورند و به پرسش هایشان درباره طبیعت بشر پاسخ دهند.»

او و میشل از سال 2007 کار جدی بر روی این پروژه را آغاز کردند. همه کتاب هایی که در کتابخانه دیجیتالی گوگل است در مالکیت عموم نیست، بنابراین محققان باید دقت می کردند تا از قانون کپی رایت تخطی نکنند. در اصل، آنها واژه ها را از متن کتاب ها برداشتند و داخل یک جدول فرکانسی عظیم سازمان دادند.

آنها داده هایشان را از صافی هایی گذراندند تا آنها را تا حد امکان دقیق کنند. برای مثال کتاب هایی که تاریخ انتشارشان ناصحیح یا متنشان به شکلی ضعیف رونویسی شده بود را به وسیله نرم افزار وجین کردند. بعد از فیلتر کردن، آنها ماندند با 5,195,769 کتاب، حاوی متن هایی با بیشت از 500 میلیارد واژه که حدود 72 درصدشان واژه های انگلیسی بودند.

محاسبات فشرده ای لازم بود تا داده ها براساس دفعات تکرار هر واژه که به وسیله ماشین آلات متعدد گوگل توزیع شده بود محدود شود و به سرعت کامل شود.

جان کلینبرگ، استاد علوم رایانه ای دانشگاه کورنل می گوید که تکرار واژه می تواند ابزار کمی قدرتمندی برای تشخیص گرایش ها در فرهنگ باشد. او می گوید:«نگاه کردن به رفتار تک تک واژه ها اغلب می تواند اولین شاخص قوی از یک پدیده در طول زمان باشد.» به هر صورت موارد اسکن شده فقط برای شروع هستند. متن های دیجیتالی دیگر هم منابع غنی ای برای مطالعه کمی اطلاعات فرهنگی فراهم می کنند. برای مثال، تجزیه و تحلیل اصطلاحات جست و جوی گوگل آشکار می کند که مردم به چه چیزهایی علاقه مندند. یا مطالعه به روز شدن فیس بوک در مقیاس وسیع می تواند به عنوان یک پالس واقعی زمانی توده ها را بررسی کند.

او می گوید:«ما چیزهایی را می بینیم که هرگز قبلاً نوشته نشده اند. روی توییتر یا فیس بوک، میلیون ها نفر می گویند که «من خوشحالم» یا «احساس غم می کنم». تا ده سال پیش کجا شما می توانستید میلیون ها نفر را پیدا کنید که احساسشان رابنویسند؟»

امتیاز به مطلب

سوالات متداول

ما از واژه ساخته شده ایم درباره چیست؟expand_more

محمدرضا کریمی ژنوميكس به مطالعه ژن ها و عملكردشان مي پردازد. در تحقيقات مربوط به ژنوميكس مقادير عظيمي از داده ها تجزيه و تحليل مي شود تا درباره اين كه چگونه ژن ها عمل مي كنند و تغيير مي كنند مطالعه شود. ژنوم هم حاوي اطلاعات ارثي است كه از نسلي به نسلي ديگر رسيده.…

share
محمدرضا کریمی

محمدرضا کریمی

روزنامه‌نگار و تحلیل‌گر ارشد مجله ویکی وبیا
مشاهده همه مقالات

بیش از ۷ سال سابقه تولید محتوا و گزارشگری در زمینه فناوری‌های نوین، اقتصاد دیجیتال و دگرگونی‌های اجتماعی. پیگیر اخبار استارت‌آپ‌های پیشگام و تحلیل‌های مستند.

rocket_launchسرزمین های دیگرstarsگزارش ویژه تحریریه ویکی وبیا

ما از واژه ساخته شده ایم

محمدرضا کریمی ژنوميكس به مطالعه ژن ها و عملكردشان مي پردازد. در تحقيقات مربوط به ژنوميكس مقادير عظيمي از داده ها تجزيه و تحليل مي شود تا درباره اين كه چگونه ژن ها عمل مي كنند و تغيير مي كنند مطالعه شود. ژنوم هم حاوي اطلاعات ارثي است كه از نسلي به نسلي ديگر رسيده.…

ما از واژه ساخته شده ایم
photo_cameraتحریریه ویکی وبیا
منشور کوروش

محمدرضا کریمی

منشور کوروش

ژنومیکس به مطالعه ژن ها و عملکردشان می پردازد. در تحقیقات مربوط به ژنومیکس مقادیر عظیمی از داده ها تجزیه و تحلیل می شود تا درباره این که چگونه ژن ها عمل می کنند و تغییر می کنند مطالعه شود. 

 ژنوم هم حاوی اطلاعات ارثی است که از نسلی به نسلی دیگر رسیده. کلماتی که ما مورد استفاده قرار می دهیم و داخل کتاب ها می نویسیم هم از نسلی به نسلی دیگر می رسند. 

بنابراین می توان واژه ها را هم یک واحد فرهنگی در نظر بگیریم.

ایدن و ژان باپتیست میشل مدیران «برنامه دینامیک تکاملی» دانشگاه هاروارد، واژه کالچرومیکس را برای تحقیقشان به کار می برند. اصطلاحی که آنها مورد استفاده قرار می دهند، ترکیبی از واژه های کالچر به معنی فرهنگ و ژنومیکس است. اولین میوه کار آنها ایجاد پایگاه عظیم داده ها از واژه های 5.2 میلیون کتابی است که بین سال های 1800 و 2000 منتشر شده است. این میزان کتاب تقریباً چهار درصد همه کتاب های منتشر شده جهان است. آنها در تحقیقشان از پروژه کتاب های گوگل استفاده کردند که کتابخانه اش حاوی 15 میلیون کتاب است.

گوگل نرم افزاری دارد که به همه اجازه دسترسی و تجزیه و تحلیل پایگاه داده های تکمیل شده که حاوی دو میلیارد واژه و عبارت است را می دهد.

محققان می گویند که دانشمندان حوزه های علوم اجتماعی و رایانه و همچنین ریاضیدانان می توانند با پیدا کردن دفعات استفاده از هر واژه، ظهور و تکامل گرایش های فرهنگی را در طول زمان دریابند. ابزار آنها را می توان برای ایجاد جدول زمانی فرهنگی مورد استفاده قرار داد. این ابزار استفاده اندک یا زیاد از واژه های بخصوصی را هم نشان می دهد.

برای مثال واژه توقیف، یک نشانه در تاریخ فرهنگ به جا می گذارد. کتاب های آلمانی زبانی که بین سال های 1936 و 1944 و در دوره سانسور حکومت نازی ها منتشر شدند به ندرت به هنرمندان و فلاسفه مشخصی که بردن نام هایشان قبل و بعد از آن دوره متداول بوده است اشاره می کنند.

همچنین تجزیه و تحلیل ها کلماتی را نشان می دهند که در کتاب های انتشار یافته در این دوره وجود داشته اند اما جایی در لغت نامه ها ندارند. از جمله این کلمات می توان به”aridification”  (به معنی خشک کردن یک منطقه) و deletable (ریشه این کلمه یعنی واژه delete به معنی حذف است) اشاره کرد. این کلمات که به هیچ منبع اطلاعاتی ای متصل نشده اند استثنائات ندارند. بعد از این که محققان همه واژه های موجود در لغت نامه های انگلیسی را جمع بستند بیش از یک میلیون واژه – دو برابر تعداد واژه های موجود در لغت نامه های بزرگ امروزی کلمه شمردند. (برای مثال لغت نامه انگلیسی آکسفورد کمتر از 500 هزار نوشته دارد.)

ایدن امیدوار است محققان بسیاری از رشته ها راه های جدیدی برای بهره برداری از این داده ها پیدا کنند. وی می گوید:«این ابزار دیگری است که در دسترس انسان شناسان قرار گرفته تا بینشی نو به دست آورند و به پرسش هایشان درباره طبیعت بشر پاسخ دهند.»

او و میشل از سال 2007 کار جدی بر روی این پروژه را آغاز کردند. همه کتاب هایی که در کتابخانه دیجیتالی گوگل است در مالکیت عموم نیست، بنابراین محققان باید دقت می کردند تا از قانون کپی رایت تخطی نکنند. در اصل، آنها واژه ها را از متن کتاب ها برداشتند و داخل یک جدول فرکانسی عظیم سازمان دادند.

آنها داده هایشان را از صافی هایی گذراندند تا آنها را تا حد امکان دقیق کنند. برای مثال کتاب هایی که تاریخ انتشارشان ناصحیح یا متنشان به شکلی ضعیف رونویسی شده بود را به وسیله نرم افزار وجین کردند. بعد از فیلتر کردن، آنها ماندند با 5,195,769 کتاب، حاوی متن هایی با بیشت از 500 میلیارد واژه که حدود 72 درصدشان واژه های انگلیسی بودند.

محاسبات فشرده ای لازم بود تا داده ها براساس دفعات تکرار هر واژه که به وسیله ماشین آلات متعدد گوگل توزیع شده بود محدود شود و به سرعت کامل شود.

جان کلینبرگ، استاد علوم رایانه ای دانشگاه کورنل می گوید که تکرار واژه می تواند ابزار کمی قدرتمندی برای تشخیص گرایش ها در فرهنگ باشد. او می گوید:«نگاه کردن به رفتار تک تک واژه ها اغلب می تواند اولین شاخص قوی از یک پدیده در طول زمان باشد.» به هر صورت موارد اسکن شده فقط برای شروع هستند. متن های دیجیتالی دیگر هم منابع غنی ای برای مطالعه کمی اطلاعات فرهنگی فراهم می کنند. برای مثال، تجزیه و تحلیل اصطلاحات جست و جوی گوگل آشکار می کند که مردم به چه چیزهایی علاقه مندند. یا مطالعه به روز شدن فیس بوک در مقیاس وسیع می تواند به عنوان یک پالس واقعی زمانی توده ها را بررسی کند.

او می گوید:«ما چیزهایی را می بینیم که هرگز قبلاً نوشته نشده اند. روی توییتر یا فیس بوک، میلیون ها نفر می گویند که «من خوشحالم» یا «احساس غم می کنم». تا ده سال پیش کجا شما می توانستید میلیون ها نفر را پیدا کنید که احساسشان رابنویسند؟»

امتیاز به مطلب

سوالات متداول

ما از واژه ساخته شده ایم درباره چیست؟expand_more

محمدرضا کریمی ژنوميكس به مطالعه ژن ها و عملكردشان مي پردازد. در تحقيقات مربوط به ژنوميكس مقادير عظيمي از داده ها تجزيه و تحليل مي شود تا درباره اين كه چگونه ژن ها عمل مي كنند و تغيير مي كنند مطالعه شود. ژنوم هم حاوي اطلاعات ارثي است كه از نسلي به نسلي ديگر رسيده.…

share
محمدرضا کریمیروزنامه‌نگار و تحلیل‌گر ارشد مجله ویکی وبیا
calendar_today۱۵ اردیبهشت ۱۳۹۰
schedule۵ دقیقه مطالعه
visibilityتحلیلی و موثق
chat_bubble_outline0 دیدگاه
forumsend

مطالب مرتبط پیشنهادی

نمایش همه

موضوعات و دسته‌ها

mark_email_read

بسته تحلیلی صبحگاهی ویکی وبیا

گزیده برترین یادداشت‌ها و تحلیل‌های روز، رایگان در ایمیل شما

mail
lockحفظ حریم خصوصی شما تضمین شده است، بدون هرزنامه.